FRnOG #34 : comment on a déployé un datacentre en un clic
Vincent Bernat
10 minutes de lecture
Aussi disponible en
Classé dans
Document lié :
Voici les diapositives que j’ai présentées pour le FRnOG #34 en octobre 2021 à propos de l’automatisation du déploiement des datacentres de Blade à l’aide de Jerikan et d’Ansible. Pour plus d’informations, consultez l’article « Jerikan+Ansible : un système de gestion de configuration pour le réseau ».
La présentation a été enregistrée1 :
Transcription#
Bonjour ! Je vais vous expliquer comment, chez Blade, on a déployé des datacenters en un « clic ». Le titre est un petit peu mensonger car on a cliqué nulle part. C’est le travail commun de l’ex-équipe réseau de Blade avec mes collègues qui sont dans la salle.
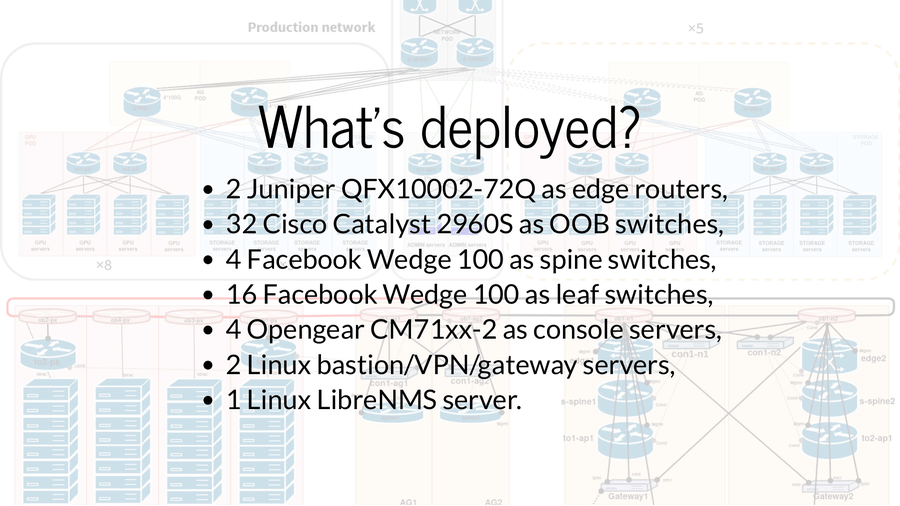
Le périmètre, c’est uniquement la partie réseau du datacenter. Des routeurs de bordure, des switchs OOB, des spines, des leafs, des serveurs de console, deux serveurs Linux qui sont centraux dans toute la gestion du réseau et un serveur LibreNMS pour la supervision.
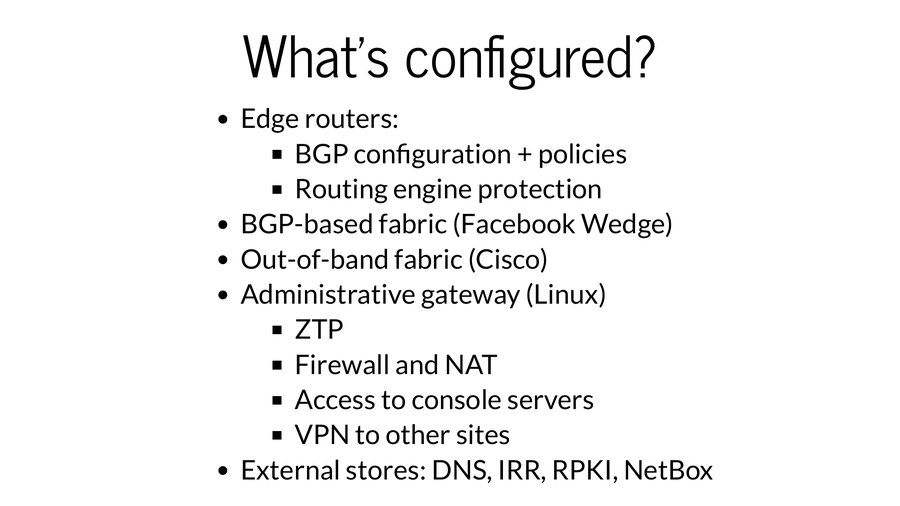
À la fin du déploiement, tout ce qui est configuré, c’est l’intégralité des routeurs de bordure, y compris les sessions BGP, les policies avec les transitaires et les peerings, une fabrique basée sur BGP, la fabrique de management out-of-band, le serveur de management qui est aussi la gateway pour le réseau de management, avec le ZTP, firewall, NAT, l’accès aux serveurs de console, le VPN vers les autres sites, ainsi que tous les systèmes externes : DNS, IRR, RPKI, NetBox. Tout ça est configuré de manière automatique à la fin du déploiement.
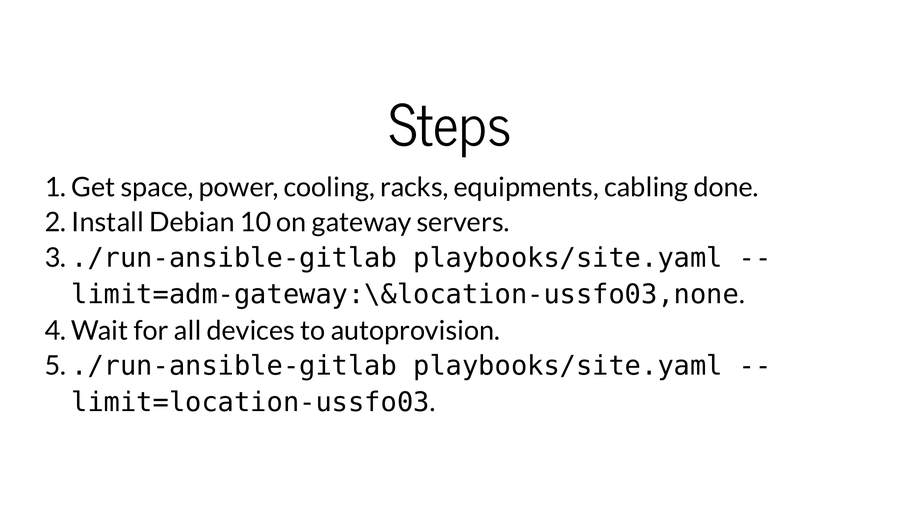
Il y a une première étape où vous devez acheter de l’espace, du power, de quoi refroidir, des racks, des équipements et brancher tout ça. Ensuite, sur les serveurs de gateway Linux, vous installez une Debian 10. Depuis votre laptop, vous lancez une petite commande qui va faire la première étape du provisioning.
Ensuite, il faut attendre un petit peu parce que tous les équipements réseau vont se provisionner en ZTP. Et on relance une deuxième fois la commande pour certains équipements comme les Cumulus que l’on considère plus comme des équipements Linux que comme des équipements constructeur. Une fois qu’ils ont eu le provisioning de base, Ansible va finaliser leur configuration. Une fois que c’est fait, on dit à notre équipe système que tout fonctionne.
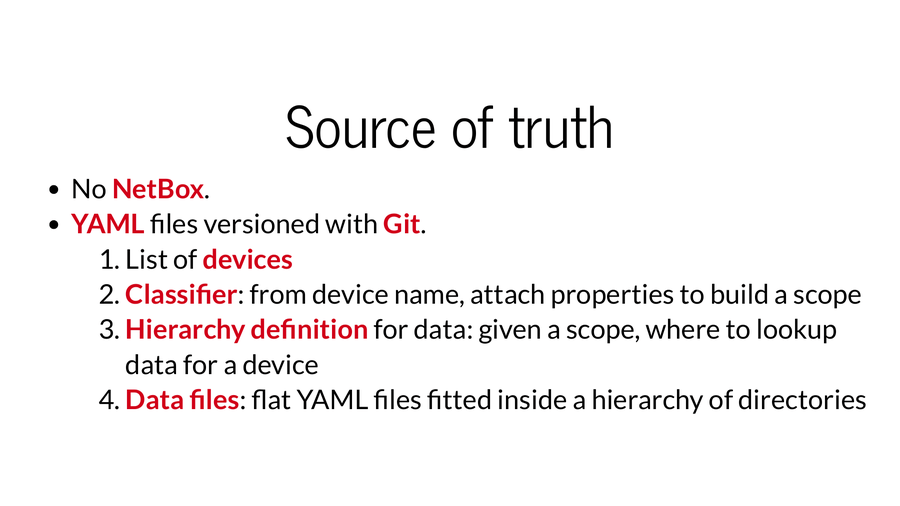
On a une base de vérité. Nous on a choisi que NetBox n’était pas notre base de vérité. On utilise NetBox, mais il est accessoire. Notre base de vérité, c’est des fichiers plats en YAML, versionnés dans Git. Ils comprennent la liste des équipements, un classifieur qui, à partir d’un nom d’équipement, donne les propriétés intrinsèques de celui-ci, une définition d’une hiérarchie pour chercher toutes les autres données, et tous les fichiers de données qui sont des YAML inclus dans cette hiérarchie.
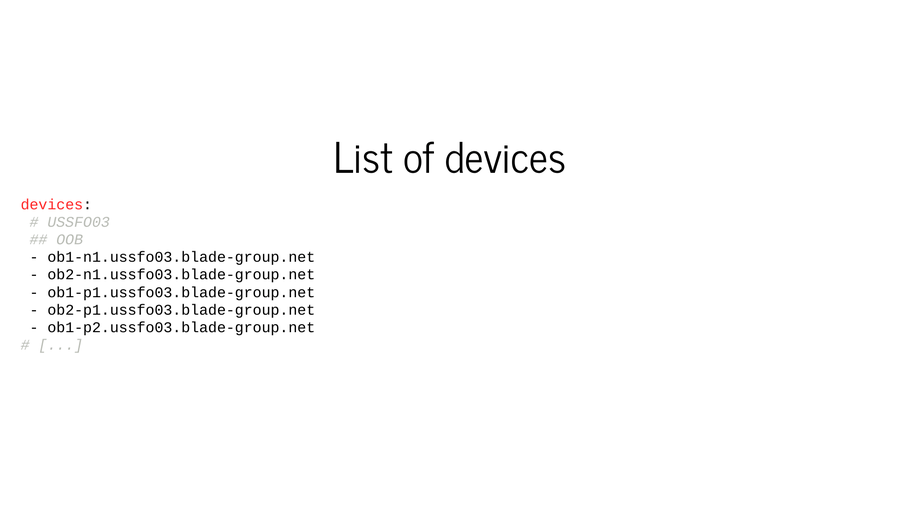
La liste des équipements est juste une liste qui contient le nom de tous les
équipements. Le nom de l’équipement implique sa fonction. Ce n’est pas
strictement nécessaire, mais c’est plus simple. Par exemple, ici, c’est un
équipement à San Francisco et ob signifie que c’est un équipement d’OOB.
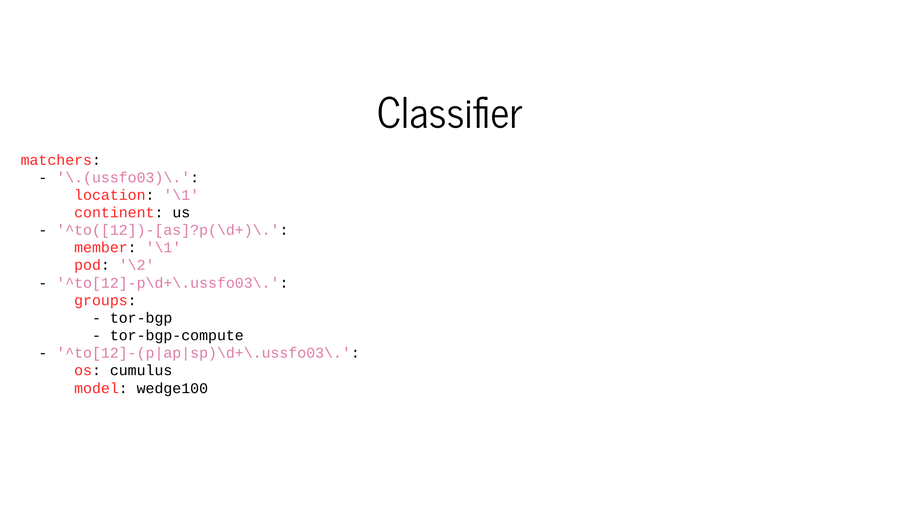
Le classifieur prend le nom de l’équipement et y attache des propriétés. Ce ne
sont que des propriétés que l’on peut déduire du nom. Il y a plusieurs types
d’informations : la localisation physique, la fonction de l’équipement… Les
to, ce sont les top-of-the-rack. Quand ils sont à San Francisco, c’est une
technologie basée sur BGP. Et quand ils s’appellent -p, c’est un pod compute.
Ils se retrouvent dans deux groupes qui donnent ces informations. Il déduit
aussi l’OS qui tourne dessus. Ce sont des Facebook Wedge 100 qui font tourner
Cumulus. Le classifieur utilise des regex pour déduire ces informations du nom.
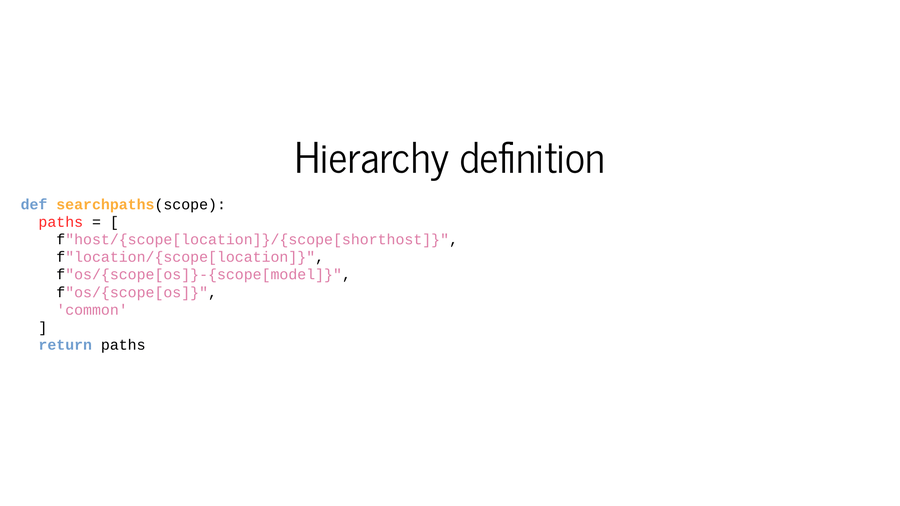
On a une définition de la hiérarchie qui, à partir des informations déduites par le classifieur, va indiquer dans quels répertoires chercher les fichiers de données.
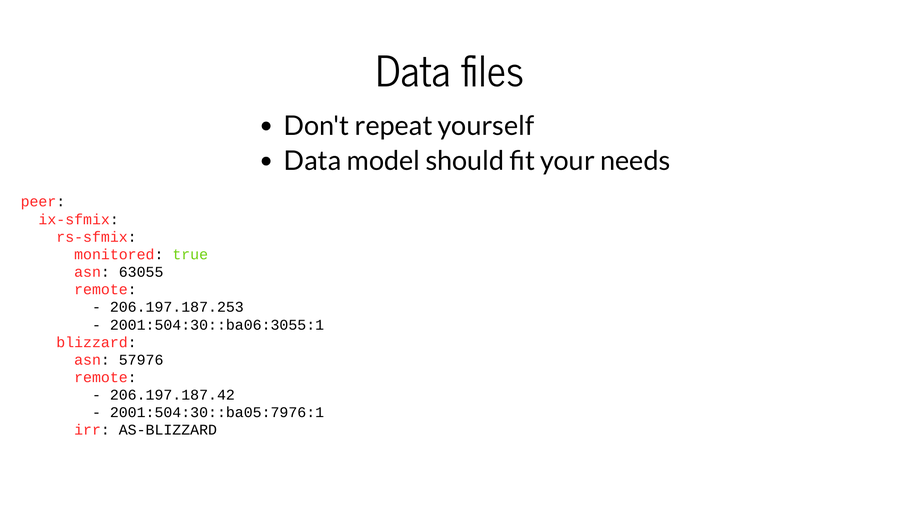
Enfin, on a tous les fichiers de données. Le modèle est libre. Une règle importante est de ne pas avoir de répétition. Si on met la même IP dans deux fichiers différents, c’est qu’il y a un problème. Quelqu’un risque de modifier une IP d’un côté et oublier de l’autre. On limite les modèles à nos besoins. On essaie pas d’inventer des besoins que l’on a pas encore. Sur cet exemple, on définit un peering sur un IX. On donne le nom du peering, l’AS, les IP. Dans ce cas avec Blizzard, on donne leur macro pour générer les filtres pour n’accepter que leurs préfixes.
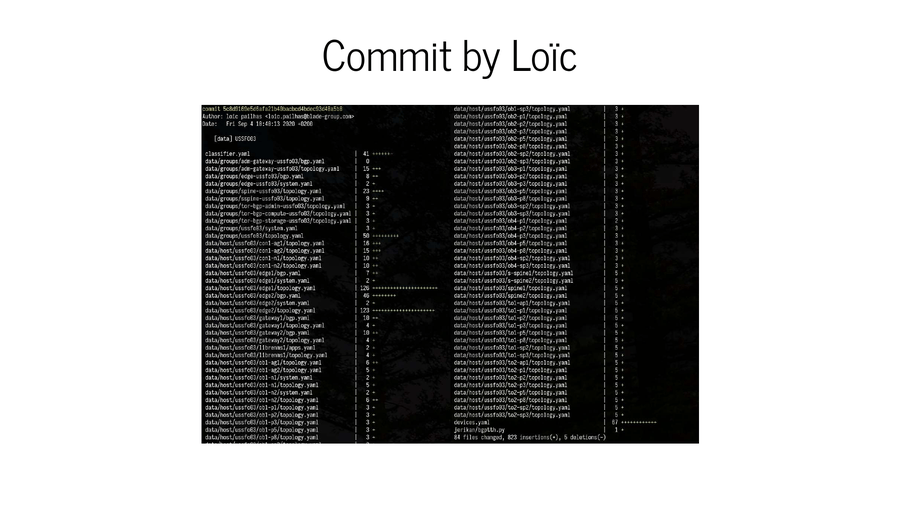
C’est un peu difficile à voir mais pour le datacenter de San Francisco, sa mise en place s’est faite en un seul commit. Ça a été préparé sur plusieurs semaines. Les données nécessaires pour déployer le datacenter sont réparties dans tous ces fichiers. Certains sont spécifiques à chaque équipement, souvent pour donner leurs adresses IP et adresses MAC. Certains sont spécifiques au datacenter ou au rack. Une fois que ce commit a été accepté, il ne reste plus qu’à déployer avec les commandes que j’ai indiquées au début.
Derrière, on a développé un soft qui s’appelle Jerikan. Sa fonction est de compiler les fichiers de configuration à partir de la source de vérité et des templates. On n’a pas utilisé Ansible pour ça parce qu’Ansible est assez lent quand il faut générer des templates. Il est assez casse-pied quand il faut les débugguer. Jerikan répond à ces problématiques. Il est extrêmement rapide. On a environ 600 équipements. Il génère l’intégralité de la configuration, y compris les routeurs de bordure avec les policies BGP de plusieurs méga, en moins d’une minute.
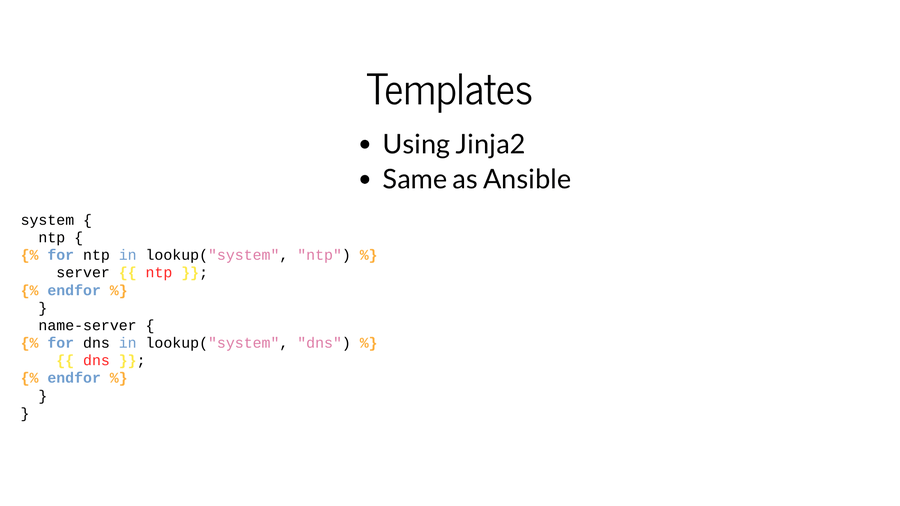
Au niveau des templates, on utilise Jinja2 car c’est ce qu’utilise Ansible et
c’est ce qui est le plus courant. On a complété avec quelques fonctions à nous
comme la fonction lookup qui permet de chercher une donnée dans la source de
vérité.
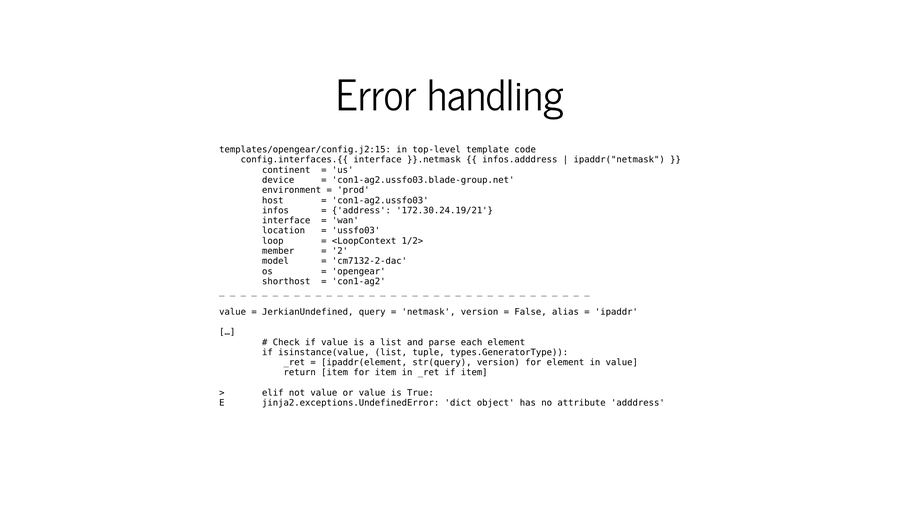
C’est un petit exemple quand il y a une erreur dans une template pour montrer la
différence avec Ansible. Il y a une erreur. On obtient la ligne sur laquelle se
situe l’erreur : la ligne 15. On a aussi toutes les variables qui sont
actuellement instanciées à ce niveau. Le dictionnaire info contient address
avec deux d et non trois d. Cela permet de voir où est l’erreur sans enlever la
moitié du template.
On a une intégration dans GitLab grâce à l’utilisation de Git. Quand Loïc voulait préparer le déploiement de San Francisco, on n’a pas arrêté les autres projets. Il fait une branche Git. Il travaille dessus autant de temps qu’il faut. Quand il est prêt à déployer, il soumet une merge request dans GitLab. Avec l’équipe on la revoie. Les gens donnent des commentaires. Il faut au moins qu’une autre personne approuve avant de pouvoir merger.
Aussi, GitLab va construire toutes les configurations et va montrer la différence par rapport à la configuration qui tourne sur les équipements. Quand on fait des petites modifications, on ne sait pas trop ce que ça va impacter. Ici, on peut dire que cette modification va faire ça. C’est assez pratique pour voir le résultat.
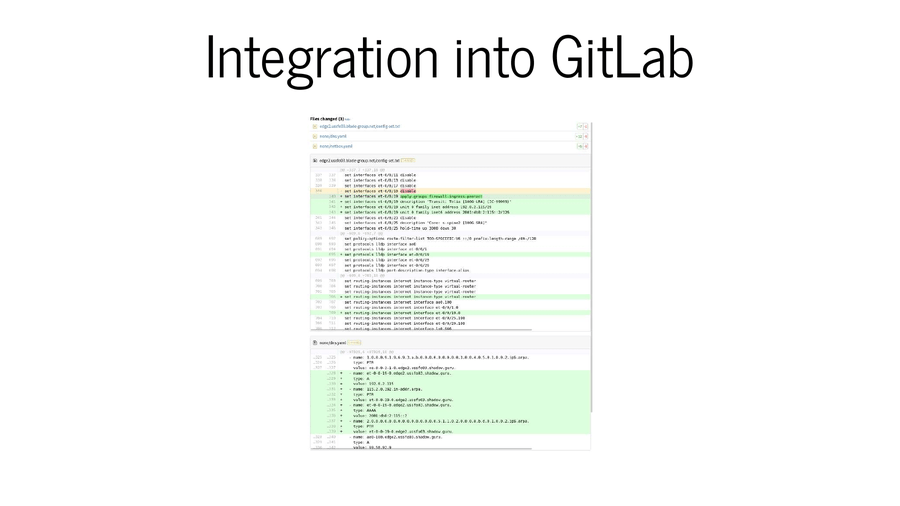
C’est un exemple de diff que l’on obtient sur un autre genre de commit. On voit qu’il y a des équipements ajoutés. Il y a un port qui s’est activé et la deuxième partie concerne le DNS.
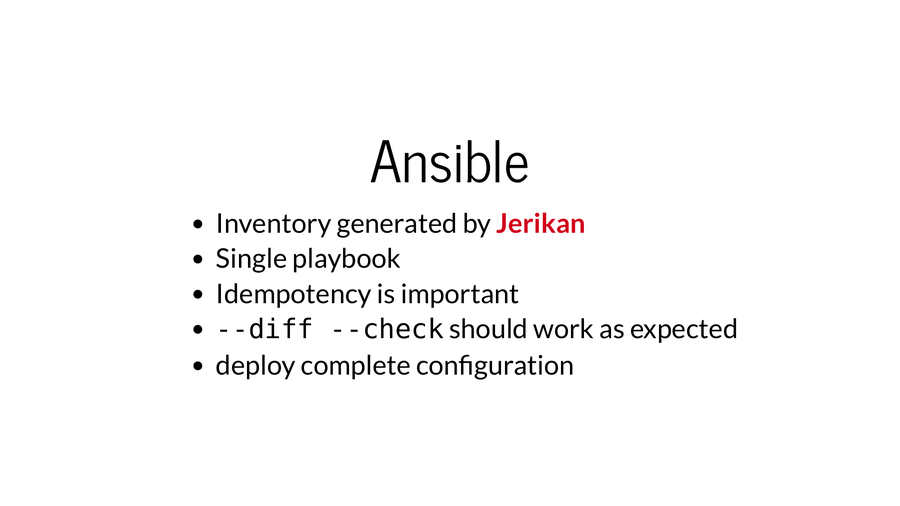
Ensuite, on garde Ansible pour toute la partie déploiement. On a des équipements très hétérogènes comme du Dell OS 9 et du HP Comware. Vous ne voudriez pas les avoir sur votre réseau mais il faut quand même les gérer. On utilise un seul playbook Ansible. On évite de le laisser tourner sur l’intégralité des datacenters.
On fait attention que les actions sont idempotentes : si on fait tourner trois
fois le playbook, il nous indique qu’il n’y a plus de modifications. On fait que
le --diff --check fonctionne, notamment que --check ne fasse pas de
modification et --diff affiche les modifications prévues. Ainsi, on peut le
faire toutes les semaines et voir si quelque chose a été modifié sans qu’on le
sache et remettre en compliance l’équipement en question. Et sur les équipements
réseau, on déploie des configurations complètes pour s’assurer que l’on fait
tourner exactement ce à quoi on s’attend.
Si vous voulez plus de renseignements, il y a un blog post avec une démo vidéo qui rentre plus dans le détail.
On a tout mis dans un dépôt GitHub qui contient Jerikan, nos playbooks Ansible et toutes les données pour les datacenters de San Francisco et de Corée du Sud qui n’existent plus actuellement. C’est les données complètes. On a pas changé les IP. On a pas enlevé la moitié. Si vous avez de quoi acheter une quarantaine de racks, vous devriez pouvoir redéployer la même chose en tapant les commandes.
Il y a aussi les configurations générées. Si la partie automatisation ne vous intéresse pas parce que vous avez déjà quelque chose, jetez un coup d’œil aux configurations générées, notamment la configuration des routeurs de bordure, les filtres BGP. Cela permet de voir un peu à quoi cela ressemble. C’est assez intéressant car dans notre industrie, on a beaucoup d’exemples très simples et jamais un exemple complet. Là, si vous voulez une fabrique BGP, deux routeurs de bordure, vous avez la configuration de A à Z.
Questions#
Ma question portait sur le fait que vous dites que vous déployiez tout par Ansible. Est-ce que vous avez rencontré des soucis ? Est-ce que vous utilisez des modules spécifiques ? Par rapport à certains constructeurs, il n’y a pas forcément des modules Ansible disponibles. Dans ce cas, comment vous procédez ?
Cela dépend du constructeur. On n’utilisait pas Ansible Galaxy à l’exception des modules constructeurs. En ce qui concerne Juniper et Cisco, on utilisait soit les modules communautaires, soit les modules du constructeur. Avec Juniper, on utilisait NAPALM. Pour Cisco, on utilisait le module communautaire. Pour Cumulus, on le considérait comme un Linux et on utilisait pas de module spécifique.
Pour vos données sensibles, vous les chiffrez dans le git par quel moyen ?
Toute la partie Jerikan ne manipule aucun secret. On utilisait des clefs SSH pour les utilisateurs. Pour les mots de passe root, ils sont hashés et on considère ça assez robuste. Pour tous les secrets qui doivent être en clair, c’est Ansible qui les manipule et ils sont stockés dans un Vault. Le déploiement se fait depuis nos laptops. On fournit à Ansible le token Vault. Dans la partie GitLab et templates, il n’y a pas de secrets.
Dans Jerikan, pour les données qui sont sous forme de dictionnaires imbriqués, est-ce que tu as choisi un merge récursif ou est-ce que tu fais comme Ansible avec un seul niveau ?
Le merge ne se fait qu’au premier niveau. On a un schéma qui indique pour certaines structures de données comment on peut les merger. Mais quand on les merge, on ne le fait que sur un seul niveau.
Pourquoi ne pas avoir utilisé NetBox ou une base de données et utiliser des fichiers plats YAML ?
On n’utilise pas de base de données. On aurait pu mixer un bout dans NetBox et un bout dans les fichiers plats. L’intérêt de tout faire dans des fichiers plats, c’est une unique source de vérité. Une base de données, c’est difficile à forker. Si vous avez un NetBox et que vous devez modifier quelque chose, puis dans des fichiers plats, il y a une désynchro.
Déployer un datacenter, cela peut être un mois de travail. Le changement de schéma peut impacter le travail des autres. L’intérêt d’utiliser Git est de pouvoir tout faire dans une branche sans impacter les autres. C’est facile à rollback. Si on se trompe dans NetBox, c’est plus compliqué à rollback. On peut utiliser une base pour des tests et une base pour la prod, mais on peut avoir deux personnes travaillant sur deux projets différents. Ici, on peut faire autant de branches qu’on veut. On a choisi de tout mettre dans des fichiers plats pour permettre d’utiliser Git jusqu’au bout.