ClickHouse San Francisco Bay Area Meetup : Akvorado
Vincent Bernat
25 minutes de lecture
Aussi disponible en
Classé dans
- présentations
- réseau > supervision
- projet > Akvorado
Document lié :
Voici les diapositives que j’ai présentées lors d’un meetup ClickHouse Bay Area en juillet 2022, organisé par Altinity. Elles portent sur Akvorado, un collecteur et visualisateur de flux réseau, et notamment sur la façon dont il s’appuie sur ClickHouse, une base de données orientée colonnes.
La réunion a été enregistrée et est disponible sur YouTube. Voici la partie qui concerne ma présentation, avec des sous-titres1 :
J’ai eu quelques questions sur la façon d’obtenir des informations des couches supérieures, comme HTTP. Comme mon cas d’utilisation d’Akvorado se situait à la périphérie du réseau, mes réponses étaient principalement négatives. Cependant, comme sFlow est extensible, lorsque vous collectez des flux à partir de serveurs Linux, vous pouvez intégrer des données supplémentaires et les exporter également.
J’ai également reçu une question sur l’agrégation dans une seule
table. ClickHouse peut agréger automatiquement des données en
utilisant le TTL. Ma réponse pour ne pas le faire est partielle. Il y
a une autre raison : les périodes de rétention des différentes tables
peuvent se chevaucher. Par exemple, la table principale conserve les
données pendant 15 jours, mais même pendant ces 15 jours, si je fais
une requête sur une fenêtre de 12 heures, il est plus rapide
d’utiliser la table agrégée flows_1m0s, sauf si je demande quelque
chose sur les ports et les adresses IP.
Transcription#
Bonjour. Je suis Vincent Bernat. Je suis un ingénieur réseau français qui travaille chez Free. Je fais cette présentation depuis Paris, France. C’est un plaisir de vous voir. Je vais vous présenter Akvorado, un collecteur et visualiseur de flux réseau utilisant ClickHouse.
Il a été développé en interne chez Free. Free est un FAI français fondé en 1999. C’est l’un des tous premiers fournisseurs d’accès accessible sans abonnement et sans numéro surtaxé en France. Il a contribué à la démocratisation de l’ADSL en France en faisant baisser les prix. Il a été particulièrement innovant avec l’introduction de la Freebox. Il s’agit de la première boîte d’accès « Triple Play », incluant Internet, télévision et téléphone. Il a aussi beaucoup contribué à l’adoption d’IPv6 en France en 2008. L’offre mobile a aussi été très innovante avec un quota de données très élevé. Actuellement, il y a plus de 100 Go inclus et vous pouvez l’utiliser un peu partout dans le monde. Mais nous ne sommes pas disponibles à San Francisco.
Akvorado est un collecteur NetFlow, IPFIX, sFlow. Les routeurs envoient un extrait des paquets qu’ils reçoivent à Akvorado, quelque chose comme un paquet sur 10000.
Il y a plusieurs protocoles pour ça. IPFIX est la version IETF de NetFlow. Netflow est un protocole propriétaire de Cisco. sFlow est un autre type de protocole. La différence est qu’il n’agrège pas les données. Il les envoie en temps réel. Mais c’est une différence mineure car NetFlow est aussi capable d’envoyer les données quasiment en temps réel avec la bonne configuration. Vous pouvez obtenir un retard de 10 secondes. En pratique, vous choisissez le protocole que vos routeurs savent gérer. Il est donc important de comprendre plusieurs protocoles car tous les routeurs ne proposent pas tous les protocoles.
Akvorado reçoit les flux et les enrichit avec des informations supplémentaires. Notamment, il ajoute les informations liées à la localisation en utilisant les bases de données de Maxmind. Il ajoute les noms et les descriptions des interfaces en utilisant le protocole SNMP. Il ajoute les numéros d’AS. Les numéros d’AS sont le moyen d’identifier les organisations sur Internet. Depuis l’adresse IP, vous obtenez le numéro d’AS et le numéro d’AS vous permet d’obtenir le nom.
On ajoute également certains attributs aux routeurs en utilisant des règles de classification : on ajoute la localisation, le rôle, le propriétaire du routeur et on ajoute également des attributs aux interfaces : le fournisseur, la frontière, la connectivité (est-ce qu’il s’agit d’une interface de transit ou de peering). Ces informations sont très utiles à avoir quand vous avez besoin d’interroger les données récoltées.
Ensuite, Akvorado sérialise les flux avec Protobuf et les envoie vers un cluster Kafka. Depuis récemment, c’est un projet libre. Nous l’avons publié sur GitHub. Il y a aussi une jolie interface graphique pour interroger les données.
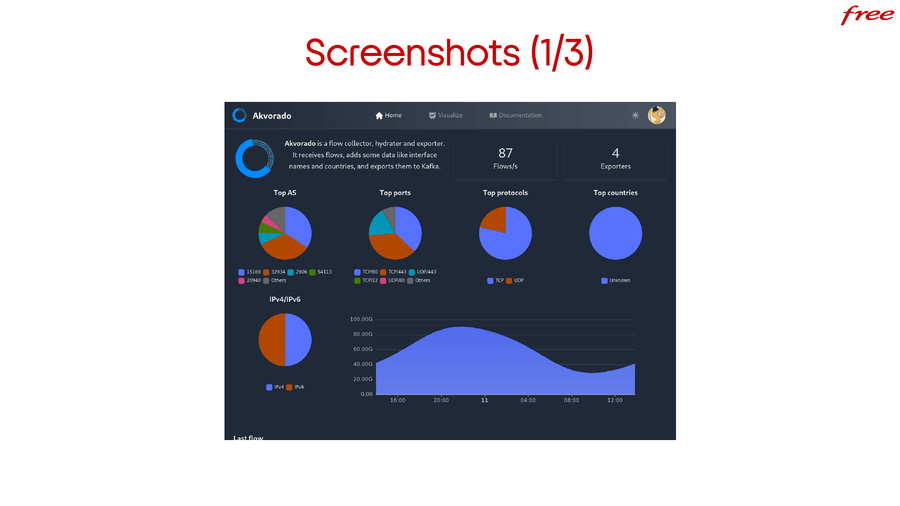
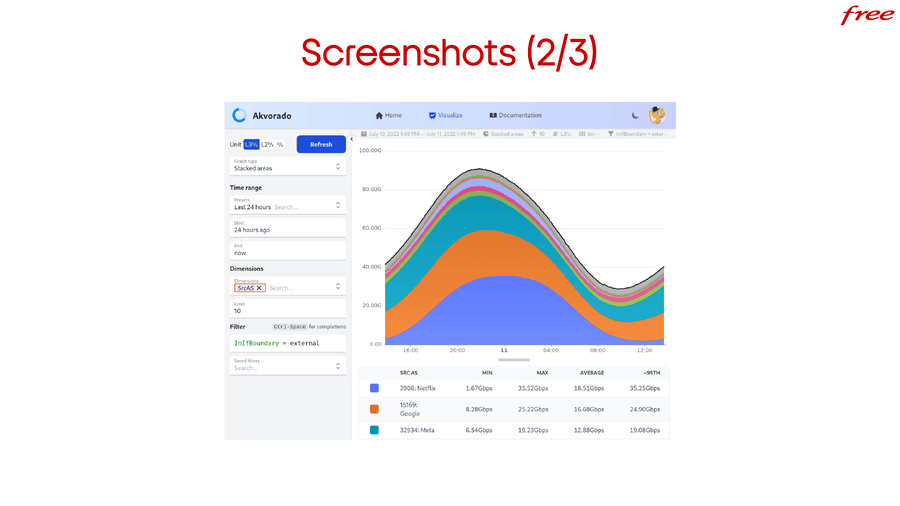
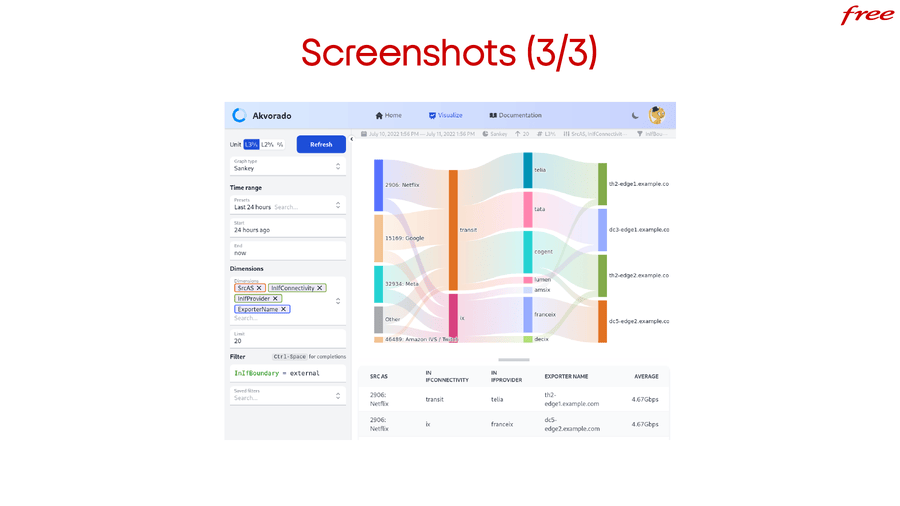
Voici quelques captures d’écran mais je vais vous faire une démonstration.
Vous pouvez essayer la démo sur demo.akvorado.net. Elle tourne sur une petite machine virtuelle et utilise des données générées.
La page d’accueil montre quelques métriques pour indiquer si tout fonctionne correctement. Elle affiche aussi le dernier flux reçu. Vous pouvez voir à quoi cela ressemble. Il y a la date de réception, le nombre d’octets et de paquets, le routeur qui a envoyé le flux, son nom.
Les attributs suivants proviennent des règles de classification. Le taux d’échantillonnage est particulièrement élevé pour cette démo. Il indique que le routeur envoie un flux pour 50000 flux reçu. L’adresse source. Le numéro d’AS source. La géolocalisation n’est pas configurée donc on n’obtient pas le pays. Vous obtenez le port source.
En ce qui concerne l’interface d’entrée, vous avez le nom, la description, la vitesse et aussi, via les règles de classification, le fait qu’il s’agit d’une interface externe (connectée à Internet). Il s’agit d’une interface de transit connectée à Cogent, qui est un fournisseur de transit et vous avez des choses similaires pour l’adresse destination, le pays et l’interface de sortie.
Il y a EType qui indique principalement IPv4 ou IPv6. Forwarding status. 64
signifie que le paquet a été routé. 128 signifie qu’il a été supprimé. Si vous
avez des règles de filtrage, c’est intéressant. Et le protocole : 17 pour UDP, 6
pour TCP. La plupart des champs sont reçus avec le flux, mais certains sont
ajoutés plus tard.
La partie la plus intéressante est l’onglet « visualisation ». Regardons sur 7 jours. Cela répond à la question « d’où vient mon trafic ? » On voit par exemple dans cette démo que la plupart du trafic provient de Netflix mais aussi de Google et de Facebook. Il y a un filtre et vous pouvez ajouter d’autres choses. Par exemple, si on ne veut voir que le trafic IPv6. Je peux mettre ce filtre et quand j’applique, j’obtiens uniquement le trafic IPv6. Comme les données sont générées, c’est un peu compliqué de voir la différence. IPv6 représente quasiment 60 Gbps tandis que le trafic total est d’environ 90 Gbps.
Une autre représentation intéressante que peut fournir l’interface web est le graphique « sankey ». On voit les trois plus gros parleurs : Netflix, Google et Facebook. Il montre aussi que les 2/3 du trafic passent par des fournisseurs de transit. Le tiers restant passe par des points d’échange.
Un point d’échange est un endroit où les gens peuvent se connecter sur le même switch et échanger du trafic gratuitement ou non. Mais vous n’avez pas la totalité d’Internet sur un point d’échange. Si vous voulez accéder à la totalité d’Internet, vous devez aussi avoir un fournisseur de transit.
On peut par exemple répondre à la question « comment obtient-on le trafic de Google ? » Il semble que le gros du trafic passe par du transit mais une petite partie vient des points d’échange. C’est une visualisation très appréciée chez les ingénieurs réseau. Retournons à la présentation.
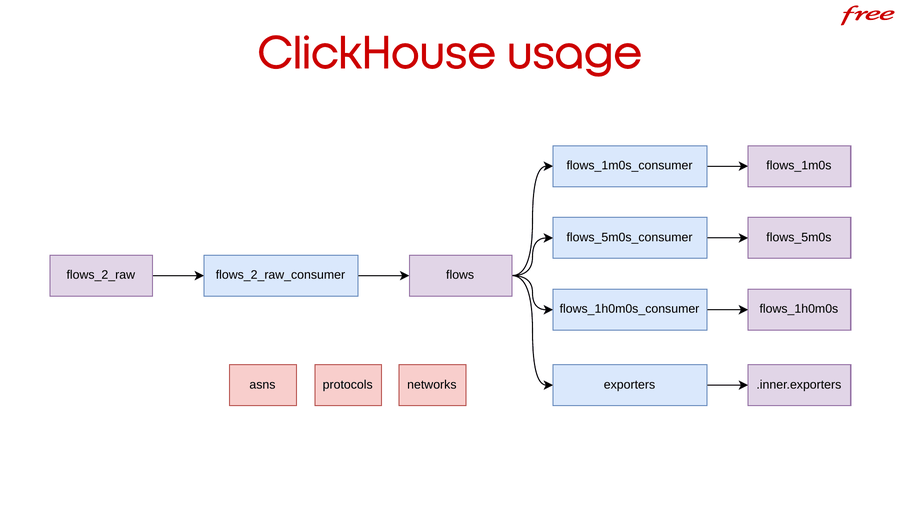
Comment avons-nous utilisé ClickHouse ? Ce sont les tables que nous avons actuellement. Petit avertissement. C’est la première fois que j’utilise ClickHouse. Je suis un ingénieur réseau et non un ingénieur de bases de données. J’ai quelques notions, mais c’est assez léger. Tout retour est le bienvenu et prenez tout avec un peu de distance.
Les rectangles violets sont les tables, ceux en bleu sont les vues et les blancs
sont les dictionnaires. J’ai été trop rapide et j’ai oublié de dire… Non, non,
c’est bon, désolé. Donc comme je vous disais, les flux arrivent de Kafka dans la
table flows_2_raw qui n’utilise pas le disque. Il y a un consommateur qui
extrait les flux et les envoie dans la table flows qui est la table principale
contenant tous les flux. Il y a quelques autres tables flows qui agrègent les
données sur le temps pour prendre moins de place et accélérer les requêtes. Je
donnerai plus de détails par la suite.
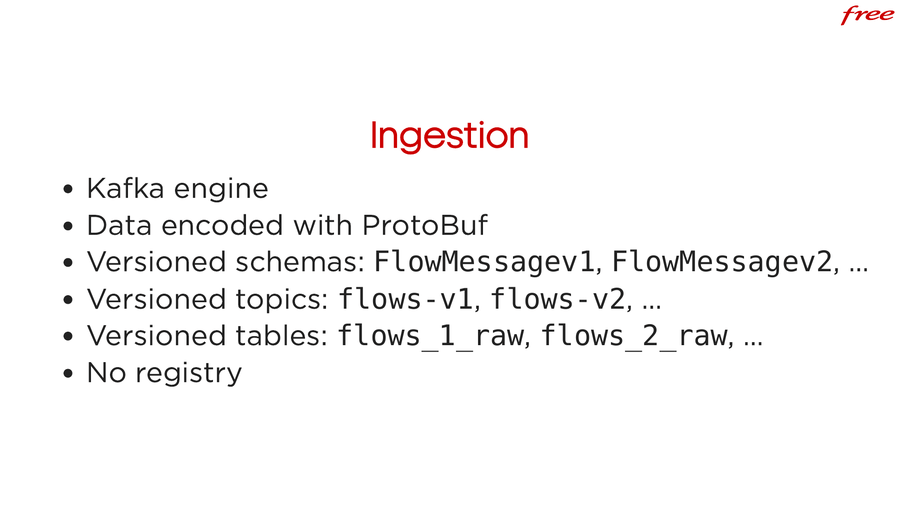
Donc l’ingestion se fait en utilisant Kafka. Nous recevons les données en utilisant le moteur Kafka. Les données sont encodées avec le format Protobuf. Les schémas Protobuf sont versionnés. Ils arrivent depuis un sujet versionné de Kafka et ils sont stockés dans des tables versionnées.
La table flows n’est pas versionnée. Les consommateurs normalisent la donnée
pour correspondre au format de la table flows. Quand il y a un changement de
schéma, on incrémente le numéro de version. Cela permet de faire des mises à
jour sans impact. Si vous avez d’anciens collecteurs qui tournent dans le
réseau, ils continuent de fonctionner. Par exemple, ils vont continuer à envoyer
des flux dans le sujet flows-v1 de Kafka. Ils utilisent le format
FlowMessagev1. Ils seront traités dans la table flows_1_raw et
flows_1_raw_consumer normalise la donnée.
Il n’y a pas de registre pour les schémas. À chaque mise à jour, il faut copier les schémas sur le serveur ClickHouse. C’est un peu embêtant mais on ne perd pas de données car Kafka garde les messages pendant que ClickHouse redémarre. ClickHouse sait utiliser un registre quand on utilise le format Avro mais je crois que cela n’est pas possible avec Protobuf.
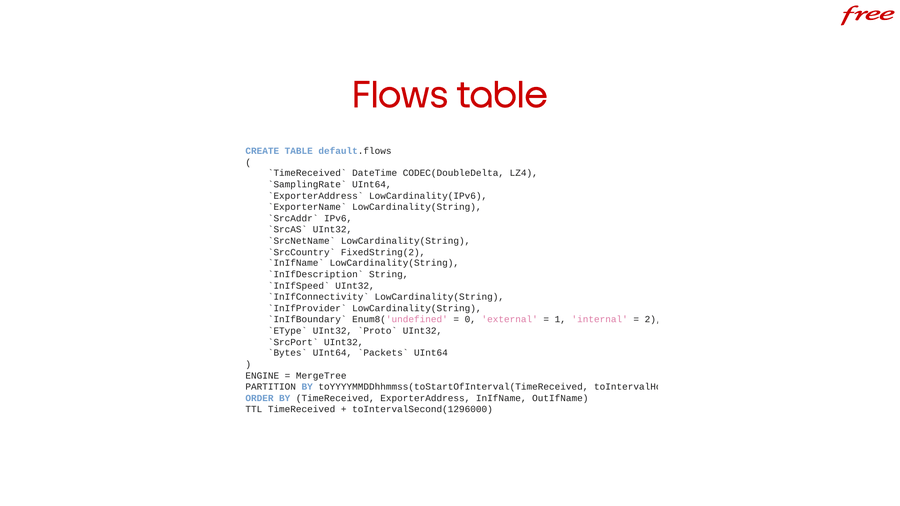
La table principale est la table flows. En voici une vue partielle. Beaucoup
de colonnes sont manquantes. Pour chaque colonne Src, vous avez une colonne
Dst. Pour chaque colonne InIf, vous avez une colonne OutIf qui correspond.
Il n’y a rien de spécial. On utilise LowCardinality quand cela a un sens et la
table est ordonnée avec TimeReceived car chaque requête va utiliser ça.
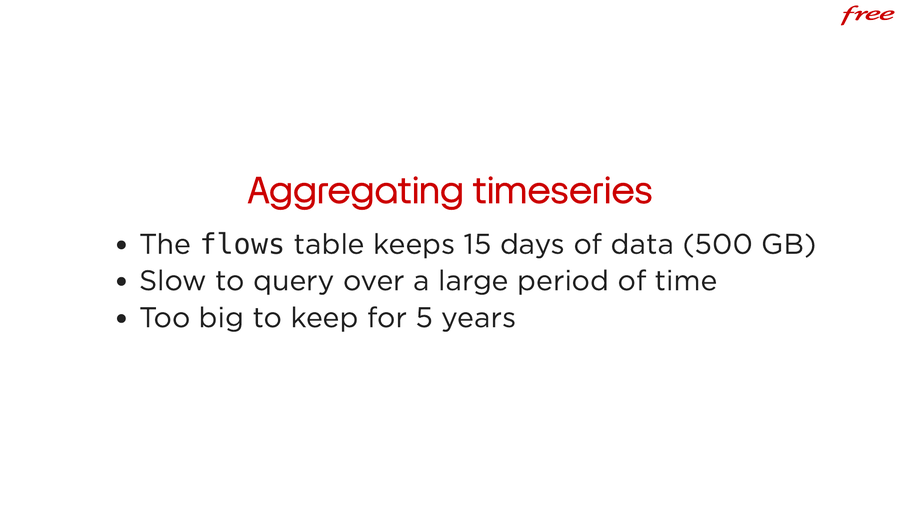
La table flows garde 15 jours de données dans notre configuration. Cela
représente 500 Go. C’est très lent d’interroger une heure de données et presque
impossible de prendre un jour, deux jours, trois jours. C’est possible, mais
très lent. Cela prend plusieurs secondes. Et on veut des réponses rapides. On
veut aussi garder les données pendant 5 ans. C’est un prérequis courant pour ce
type de besoins. On veut pouvoir regarder ce qui s’est passé il y a un an sur la
même période. Pour se faire, on doit agréger les données quand elles deviennent
plus vieilles. ClickHouse agrège les données, mais ce n’est pas assez flexible
pour nous.
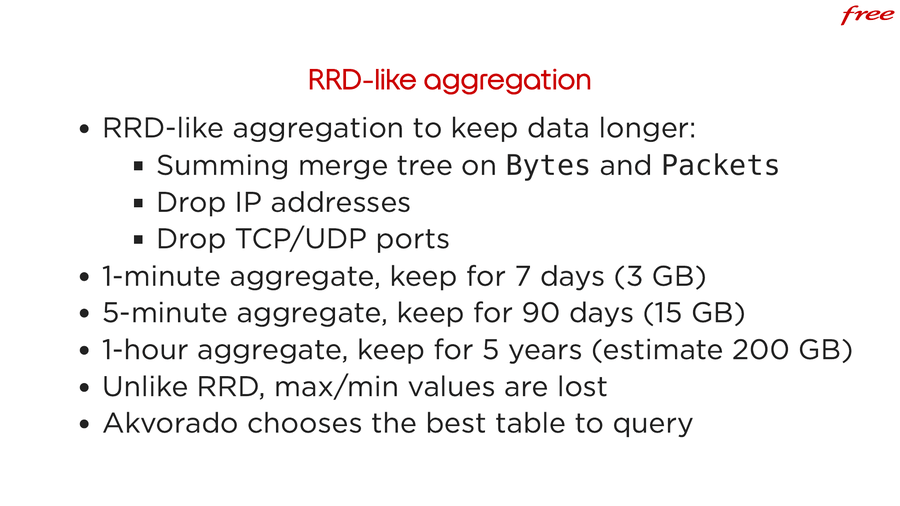
On utilise une approche inspirée des bases RRD. Les bases RRD sont les ancêtres des bases de données basées sur le temps. Les données sont stockées dans un tampon circulaire et après un certain temps les données sont consolidées en utilisant une fonction spécifique, comme min, max ou la moyenne. Nous faisons ça avec un summing merge tree sur les octets et les paquets. On retire également les adresses IP et les ports TCP/UDP.
On ne peut pas garder les adresses IP pendant trop longtemps pour des raisons légales mais aussi parce qu’elles contiennent des informations identifiant les abonnés. De plus, ce n’est pas très intéressant au-delà d’un certain nombre de jours. Les parties intéressantes des adresses IP survivent via les règles de classifications. On attache une région à une IP. Ainsi que via les numéros d’AS : on sait que cette adresse IP appartient à Facebook par exemple. Ainsi, au-delà de quelques jours, nous ne gardons pas les IP.
Pour les ports TCP et UDP, la raison est autre. Nous aurions pu les garder, mais ils sont assez aléatoires. La plupart du temps, soit le port source, soit le port destination est connu. Par exemple, les ports 80 ou 443 pour HTTP. Mais l’autre port peut être totalement aléatoire. Il n’est pas facile de savoir quel est le port serveur et ainsi, il est plus facile de ne pas les garder. De plus, passé quelques jours, ce n’est pas très intéressant de garder les ports et cela aide à compresser mieux les données. Cela aide à agréger plus efficacement les données en ne gardant pas cette information.
À la différence de RRD, on ne garde pas les valeurs maximales. C’est quelque chose qui serait à faire à un moment car quand on considère une plage de temps plus grande… Je vais vous montrer sur la démo, c’est intéressant… Vous pouvez voir ici que le maximum est autour de 60 Gbps. Mais si je demande des données sur 30 jours, le maximum est un peu plus bas. C’est parce qu’il ne s’agit pas réellement d’un maximum, mais d’une moyenne selon la résolution de la table. Une moyenne sur 5 minutes et une moyenne sur une heure, cela donne une valeur maximale différente. Mais c’est quelque chose que l’on peut sans doute corriger avec ClickHouse, je pense.
On a donc une table qui agrège sur 1 minute, une table sur 5 minutes et une table sur une heure. Elles gardent les données sur 7 jours, 90 jours et 5 ans. C’est très efficace. Akvorado choisit automatiquement la meilleure table selon la période demandée, les colonnes demandées (si vous demandez une adresse IP source, il faut utiliser la table principale).
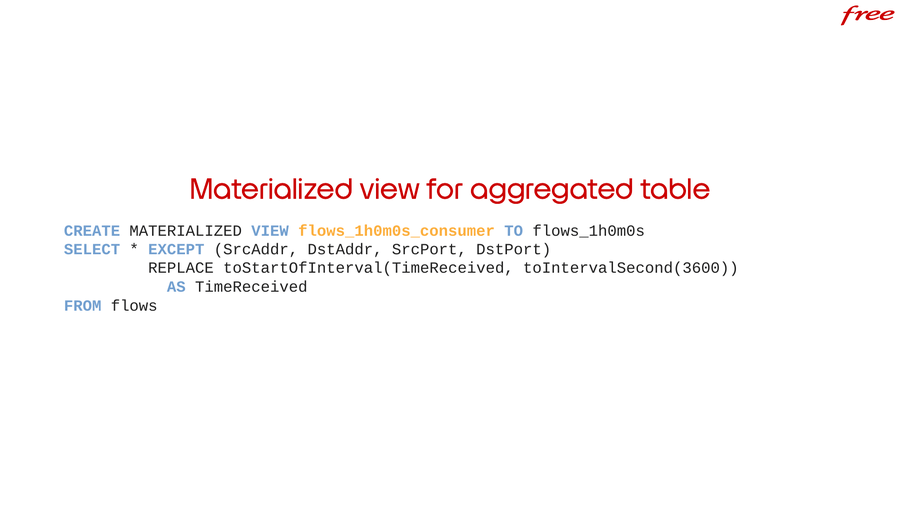
Je voulais aussi vous montrer comment on remplit une table agrégée car cela
montre une fonctionnalité assez intéressante de ClickHouse. Vous pouvez
sélectionner tout avec l’étoile, sauf quelques colonnes. On veut exclure les
adresses source et destination et les ports source et destination. C’est très
facile à faire. On peut aussi remplacer des colonnes. Par exemple, la colonne
TimeReceived est tronquée à l’heure précédente. C’est une fonctionnalité
appréciable.
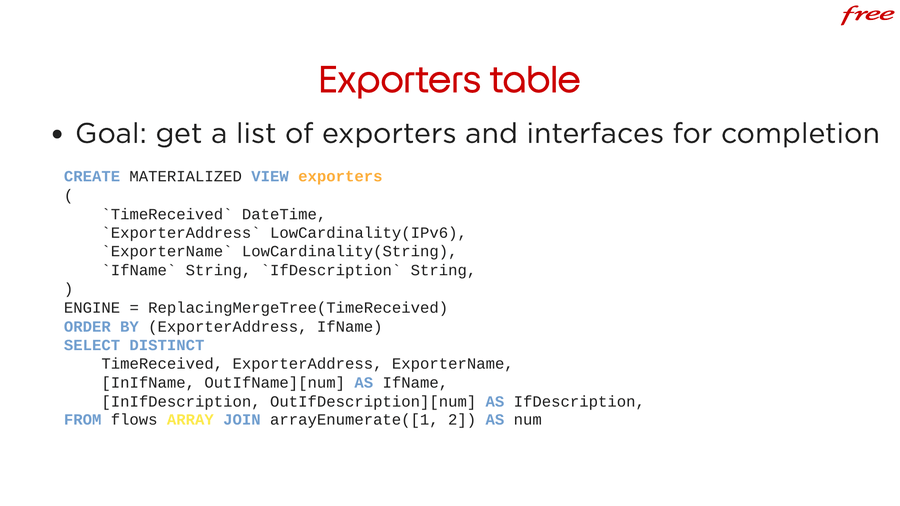
La table exporters. C’est juste une petite table pour garder une liste des
routeurs, de leurs noms et des interfaces avec leurs descriptions. Elle est
utilisée pour la complétion des filtres dans l’interface web. Je voulais vous
montrer ça pour illustrer une autre fonctionnalité intéressante de ClickHouse.
Il y a plein de moyens de manipuler des tableaux. Avec une seule requête, je
peux remplir la table avec ARRAY JOIN et arrayEnumerate.
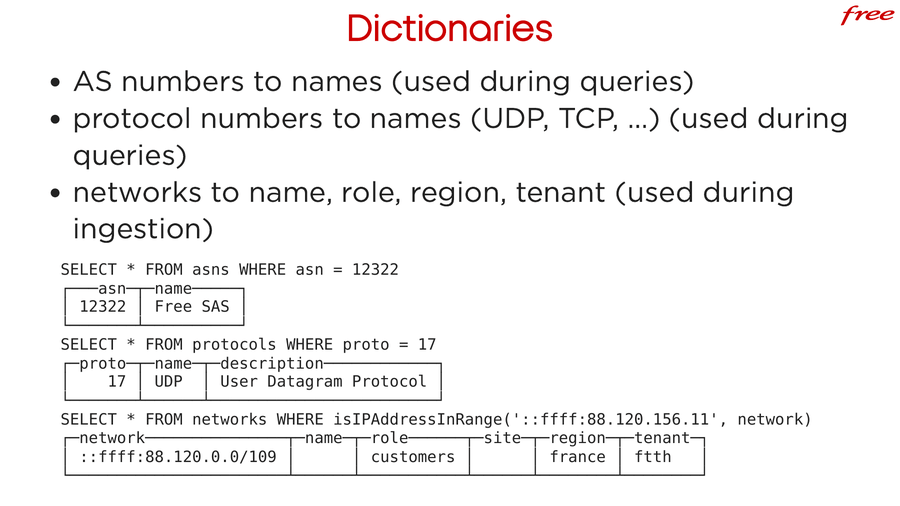
Une autre partie intéressante, ce sont les dictionnaires. On en utilise trois. Un dictionnaire pour donner un nom à chaque numéro d’AS. Il y a environ 100 000 numéros d’AS. À partir d’un numéro d’AS, vous pouvez avoir un nom.
On a un autre dictionnaire pour les numéros de protocole. Ainsi, le protocole 17, c’est UDP. Les protocoles ne changent jamais. Les numéros d’AS ne changent que de manière peu fréquentes et c’est principalement cosmétique. Par exemple, l’AS de Twitch TV peut devenir plus tard l’AS d’Amazon Twitch TV. C’est principalement cosmétique et c’est utilisé que lors de l’affichage. On utilise donc ces dictionnaires pendant les requêtes.
Le troisième dictionnaire permet de faire une correspondance entre les réseaux, comme celui-ci, et un nom, un rôle, une région et un propriétaire. Cette fois, on utilise ce dictionnaire pendant l’ingestion pour matérialiser certaines colonnes. On ne veut pas que les données historiques soient altérées quand on alloue un réseau à une région différente.
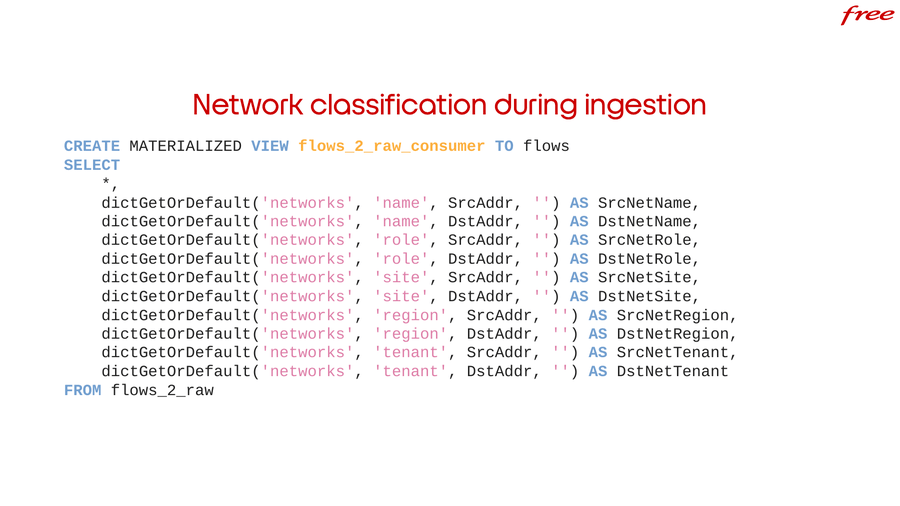
La classification des réseaux est faite à l’ingestion via la vue matérialisée où
on sélectionne tout ce que l’on reçoit depuis Kafka et on ajoute juste les noms,
rôles, etc., en utilisant le dictionnaire. Le dictionnaire networks utilise la
méthode IP_TRIE. Cela signifie qu’à partir d’une adresse IP, ClickHouse peut
rapidement effectuer une recherche pour sélectionner le réseau correspondant.
Ce ne sont pas les seules données qui sont générées à partir d’autres données. Si vous vous souvenez, on génère aussi les données de localisation, les numéros d’AS et la classification. Pour la géolocalisation, on ne le fait pas dans ClickHouse. On aurait pu le faire dans ClickHouse avec un dictionnaire. Cela aurait fonctionné, mais c’est assez simple de le faire dans Akvorado directement. La classification est faite en utilisant des règles fournies par l’utilisateur. Cette fois, c’est plus simple de le faire dans Akvorado, pas dans ClickHouse.
Si vous vous souvenez de la démo, l’utilisateur fournit une période, des colonnes (dans l’interface web, on appelle cela des dimensions) et une expression pour filtrer.
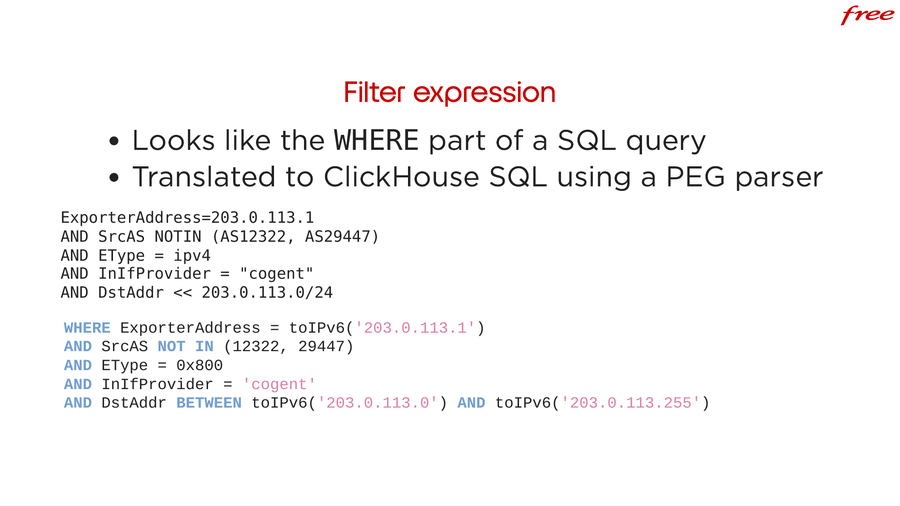
L’expression de filtre, c’est quelque chose d’assez intéressant. Nos utilisateurs sont des ingénieurs réseau. Ils peuvent connaître SQL, mais ce ne sont pas des spécialistes. On utilise donc un langage qui ressemble à SQL pour les filtres et on le traduit vers le SQL utilisé par ClickHouse avec un analyseur syntaxique.
Notre domaine est plus simple, donc on prend des raccourcis pour simplifier
certaines choses. Par exemple, on peut donner les adresses IP directement. On
peut utiliser des guillemets simples ou doubles, il n’y a pas de différences. On
peut utiliser des constantes. EType est normalement un entier, mais on peut
donner un nom. On essaie de rendre les choses plus simple. L’analyseur traduit
ça vers le SQL de ClickHouse.
C’est aussi sûr parce qu’on analyse le filtre et on construit la requête SQL. Si vous utilisez une colonne inconnue ou faites une erreur de syntaxe, ou quelque chose comme ça, l’analyseur va échouer avec un message d’erreur et on ne construit pas de requête. On ne peut pas injecter des données dans ClickHouse, même si ClickHouse n’est déjà pas très vulnérable à ce type d’attaque, ce n’est pas possible car l’analyseur doit comprendre ce que vous voulez pour le traduire à ClickHouse.
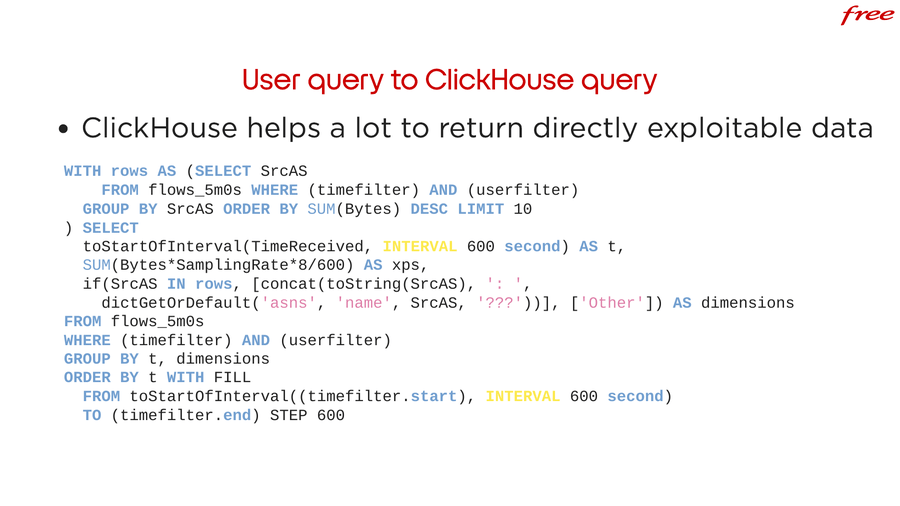
Ensuite, l’intégralité de la requête de l’utilisateur est transformée en SQL. ClickHouse aide beaucoup pour retourner des données qui sont directement utilisables par l’interface web. Ainsi, quand il y a des données qui manquent, on peut automatiquement compléter avec des 0. C’est ce qui est fait ici.
Notez que j’utilise la table agrégée à 5 minutes. Il y a une valeur magique ici, 600. On adapte la résolution demandée par l’utilisateur. Par exemple, il peut demander une valeur toutes les 632 secondes. On adapte pour correspondre à la résolution de la table. Cela doit être un multiple de la résolution de la table pour que le résultat soit correct. Comme la résolution est de 300 secondes et que l’utilisateur a demandé un point environ toutes les 600 secondes, on va lui donner un point toutes les 600 secondes.
Il y a une sous-requête. L’utilisateur a demandé à grouper selon les numéros
d’AS. On va calculer les 10 premiers AS correspondant au même filtre sur la même
période. On sélectionne les 10 plus gros AS. Pour chaque numéro d’AS que l’on
obtient, s’il fait partie du top 10, on affiche le numéro d’AS avec son nom en
utilisant le dictionnaire. Sinon, on affiche juste Others. Ainsi, on ne
retourne pas une énorme liste d’AS à l’utilisateur.
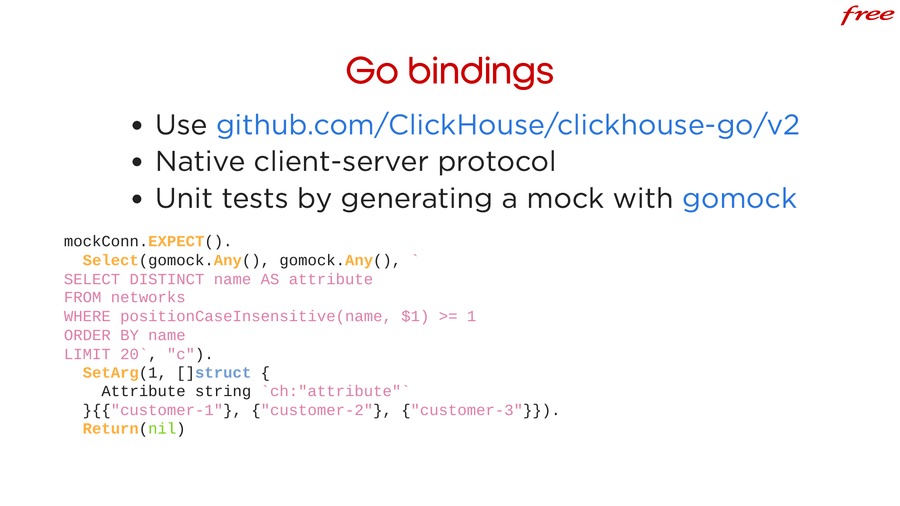
Passons maintenant à Akvorado. C’est écrit en Go. On utilise clickhouse-go/v2
qui utilise le protocole client/serveur natif. C’est une interface de bas
niveau, mais cela nous convient parce que les abstractions viennent souvent avec
des restrictions. La documentation n’est pas terrible. Elle ne correspond pas
aux standards habituels de Go. Il y a quelques exemples pour comprendre mais
cela fonctionne très bien sinon.
On écrit pas mal de tests unitaires mais ils ne tournent pas sur une vraie base
de données. Pour chaque requête, on renvoie des réponses pré-calculées en
utilisant un mock généré par GoMock. Par exemple, durant les tests, cette
requête est effectuée. GoMock génère une fausse fonction qui va répondre avec
ces résultats : customer-1, customer-2, customer-3. Cela nous permet de
faire de nombreux tests rapidement sans se reposer sur une base de données
externe.
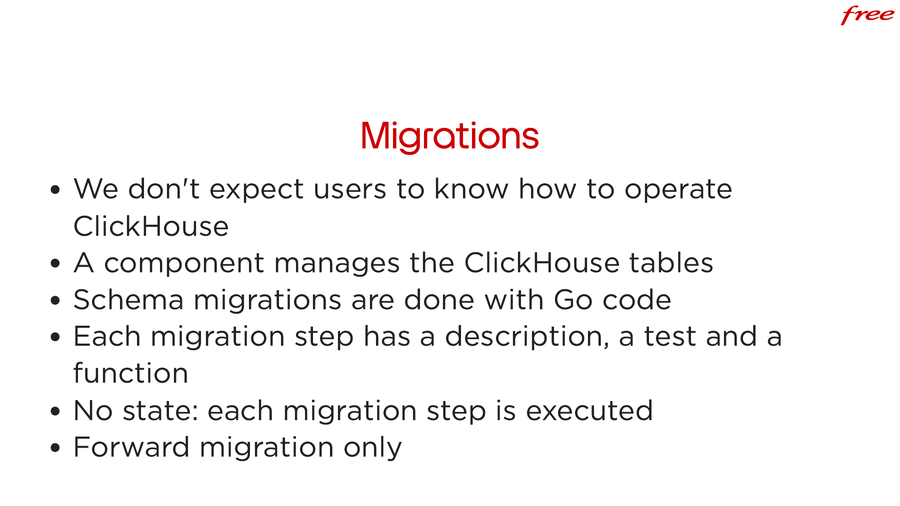
La dernière chose dont je veux parler, ce sont les migrations. Avec une base de données traditionnelle, un logiciel va souvent proposer des migrations à exécuter lors des mises à jour. Avec ClickHouse, c’est plus compliqué, parce qu’on ne peut pas faire ce qu’on veut. On a donc un chef d’orchestre qui va gérer les différents composants, internes et externes, y compris ClickHouse et Kafka. Il va gérer les migrations et c’est fait avec du code en Go. Chaque étape de migration a une description, un test et une fonction. Il n’y a pas d’état : chaque étape est exécutée au démarrage. Le test permet de sauter une étape qui n’est pas nécessaire. On ne gère pas les retours en arrière.
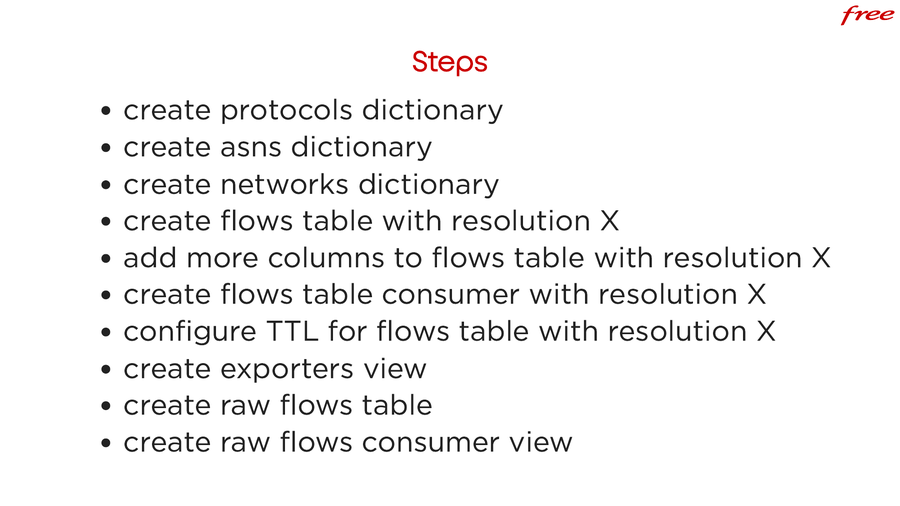
Il y a une étape pour créer les dictionnaires : protocole, ASN et réseau. Une
autre pour créer les tables flows, la principale et les agrégées. Si vous
mettez à jour depuis une ancienne version, il y a une étape qui ajoute les
colonnes manquantes. Il y a une étape pour créer les consommateurs des tables
flows. Une étape pour configurer les TTL. Cela signifie que si l’utilisateur
change la configuration des TTL et redémarre, les TTL seront effectivement mis à
jour. Et une étape pour la table exporters et les tables « raw ».
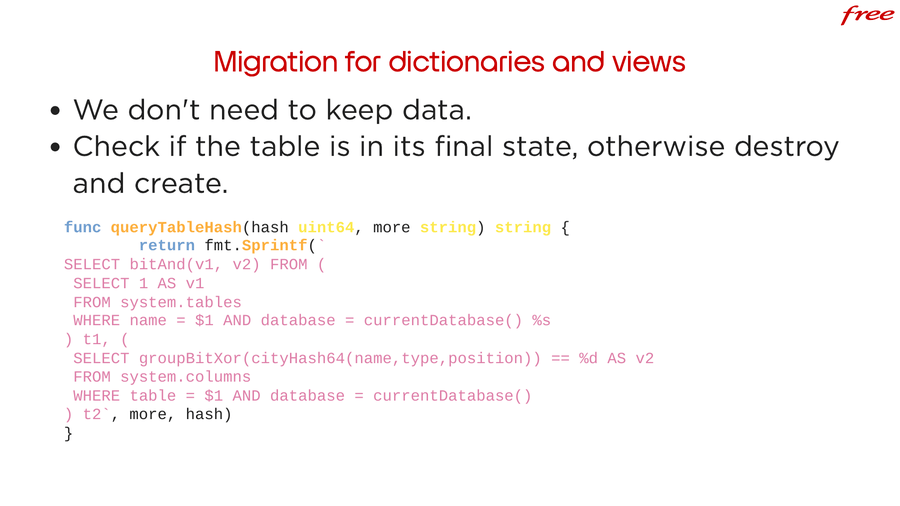
Il y a deux types d’étapes. Il y a celles qui modifient les dictionnaires et les
vues. On n’a pas besoin de garder des données pour celles-ci. On fait deux
tests. On teste si la table existe. La table, la vue ou le dictionnaire existe.
Et on teste si la table a les bonnes colonnes aux bons endroits. C’est fait en
créant un condensat du nom, du type et de la position sur la table système
columns et en le comparant à une valeur fixe. C’est pas mal que ClickHouse
expose beaucoup de choses dans les tables systèmes car cela nous permet de faire
ça.
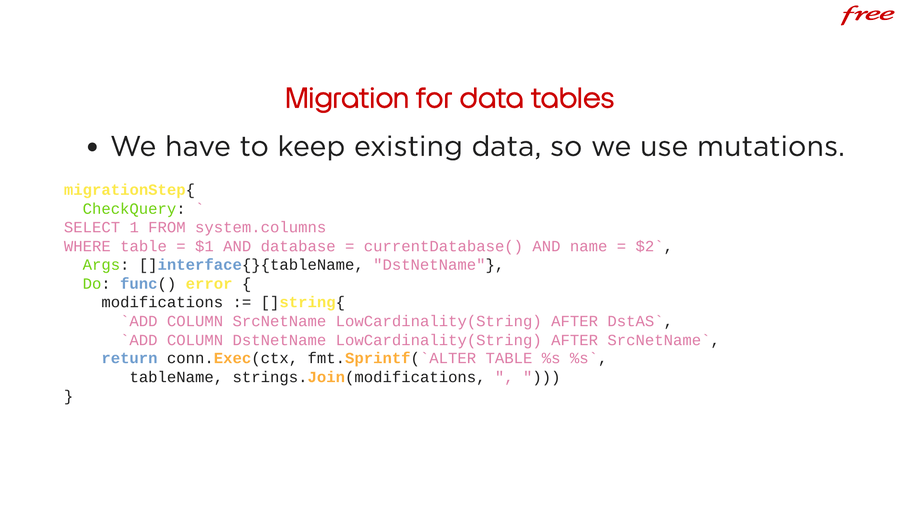
Le deuxième type d’étapes, c’est quand on veut conserver les données. Dans ce
cas, on utilise des mutations. On teste « est-ce qu’on a déjà la colonne que
l’on veut ajouter ? » Dans le cas contraire, on utilise ALTER TABLE pour
ajouter la colonne. Il y a beaucoup de limites sur ce qu’on peut modifier, mais
avec quelques compromis, jusqu’à aujourd’hui, on a été capable de faire ce qu’on
voulait.
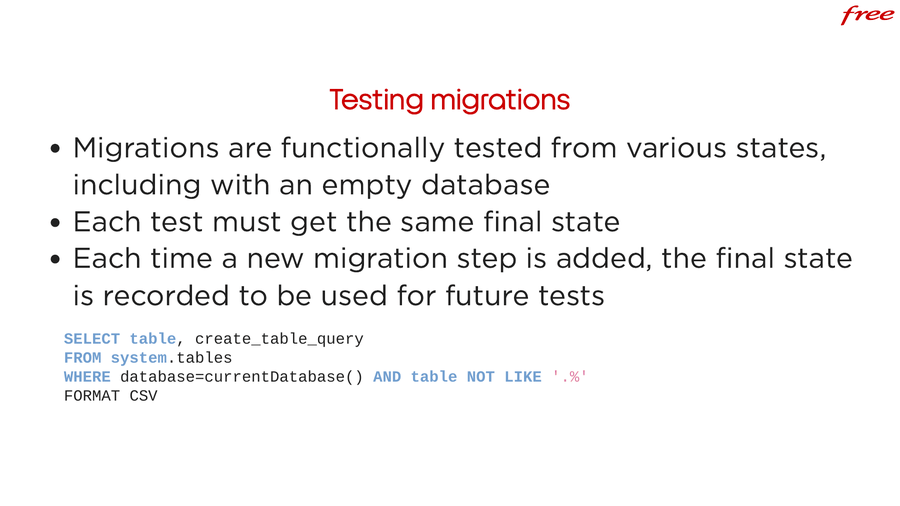
Les migrations sont testées. Cela fait partie des tests automatiques. Il y a une base de données ClickHouse qui est démarrée dans un conteneur. Les migrations sont testées depuis des états variés, incluant une base vide. Chaque test doit donner le même état final et à chaque fois qu’on ajoute une étape de migration, l’état final est enregistré pour être utilisé dans des futurs tests, via la requête affichée ici. Cela nous permet de nous assurer qu’un utilisateur peut migrer d’une version à une autre.
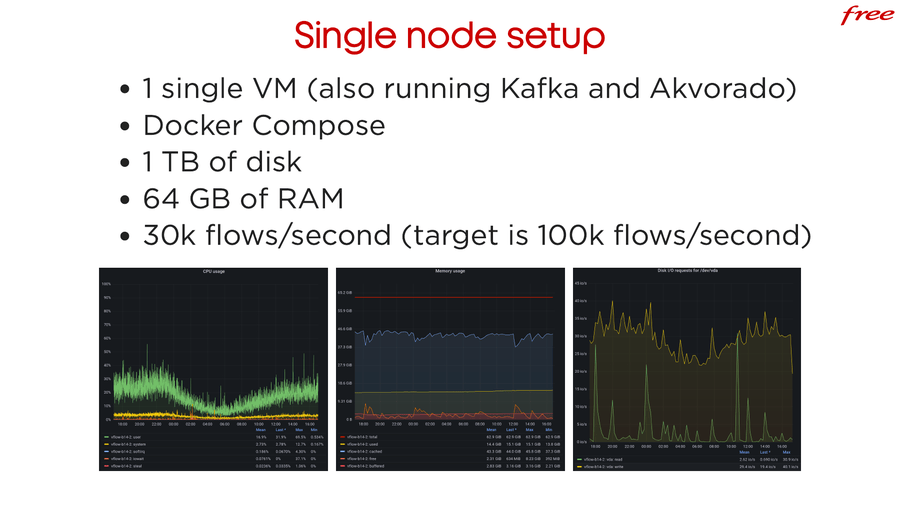
Notre configuration est plutôt petite. Tout tourne dans une seule VM, y compris
Kafka et Akvorado. On fait tout tourner dans des conteneurs avec
docker-compose. C’est une configuration très simple. 1 To de disque, 64 Go de
mémoire. Pour le moment, on a 30 000 flux/s mais la cible, c’est 100 000 flux/s.
Vous avez des graphiques pour le CPU, la mémoire et le disque. Tout est assez
faible, mais il y a aussi le système anti-DDoS qui tourne en fond, toutes les 5
secondes, en faisant des requêtes. Il génère une bonne partie de la charge.
En conclusion, mon opinion sur ClickHouse. Facile d’accès, bonne documentation. Il y a beaucoup de fonctions disponibles. Les fonctions liées aux chaînes par exemple, avec la conversion vers des quantités faciles à lire. On a vraiment l’impression que c’est quelque chose qui cherche à résoudre directement les problèmes dans ClickHouse plutôt que de déléguer cela à une autre couche. Cela donne un peu l’impression d’être magique.
Une autre solution populaire pour cet usage est ElasticSearch. Contrairement à ElasticSearch, ClickHouse est très rapide sans effort et reste très rapide. Gérer un cluster ElasticSearch est beaucoup plus difficile pour ce cas d’usage. Il faut un peu de temps pour comprendre les tables agrégées et on a vite fait de faire quelque chose qui paraît correct mais qui ne l’est pas. Par exemple, en agrégant en utilisant des moyennes, on obtient pas ce que l’on attend. Cependant, ClickHouse a des fonctions pour faire ça.
C’est tout pour moi. Avez-vous des questions ?
Questions#
Vincent, c’était un exposé absolument génial et on a quelques questions en attente. Je peux les voir. Il y en a deux de Gilad. La première est Akvorado ne prend en compte que les protocoles de la couche 3, comment il détecte de quelle application il s’agit ?
Il s’agit d’une limitation des protocoles NetFlow/IPFIX/sFlow. Ces protocoles ne collectent que des informations de couche 4. NetFlow/IPFIX sont limités aux informations de la couche 4, plus quelques métadonnées comme les numéros d’AS. sFlow peut voir plus loin à l’intérieur des paquets. Vous pouvez obtenir les entêtes de niveau 4 ainsi que 200 octets dans chaque paquet retourné. Vous pouvez faire ça mais Akvorado n’utilise pas ça pour le moment.
Vous pouvez deviner l’application en utilisant les ports ou les adresses IP. Cela dépend. Par exemple, si vous avez un cluster Kubernetes, l’adresse IP doit vous donner l’application cible. Vous pouvez utiliser ça. Pour le moment, vous ne pouvez pas vraiment savoir à coup sûr que c’est une requête HTTP. Vous ne pouvez pas savoir quelle requête HTTP a été faite. Ce n’est pas ce type d’outils.
Cool. La question suivante de Gilad a mon nom dedans, mais je ne sais pas si je peux vraiment y répondre. Gilad demande s’il ne serait pas mieux d’avoir une seule table plutôt que 3 tables. Gilad, peux-tu parler ? Je crois que tu peux parler. Qu’as-tu à l’esprit avec cette question ?
Oui. Je vois que tu as trois tables, une pour l’agrégation à 1 minute, une pour 5 minutes et une pour 1 heure. Est-ce que tu as testé avec une seule table en utilisant le TTL pour agréger les données à 1 minute, depuis de 1 à 5 minutes, puis de 5 minutes à 1 heure, tout dans la même table avec une colonne pour indiquer la résolution ?
Oui. J’ai essayé, mais quand on essaie d’agréger des données dans la même table, il y a un prérequis sur la clé primaire… Je peux me tromper mais je n’ai pas réussi à faire ça car la clé primaire ne doit pas changer.
Dans la clé primaire, nous avons TimeReceived et nous voulons la tronquer à la
minute la plus proche, aux 5 minutes les plus proches et à l’heure la plus
proche. Je peux faire ça avec une colonne pour TimeReceived, une autre colonne
avec TimeReceived tronqué à la minute, TimeReceived tronqué aux 5 minutes et
TimeReceived tronqué à l’heure. Je dois avoir les trois colonnes qui existent
pour permettre l’agrégation. Cela paraît plus compliqué mais il y a peut-être
une meilleure approche. Je serais intéressé de le savoir.
Cela aurait pu fonctionner, mais comme on ne peut pas modifier… cela veut dire que si je veux ajouter une nouvelle agrégation, par exemple en ajoutant une agrégation à 10 minutes, je ne peux pas modifier la table car la clé primaire ne peut pas changer. C’est la raison principale qui fait que j’ai choisi 3 tables même si cela rend l’application un peu plus complexe car on doit choisir la bonne table.
Je voulais dire que nous avons une solution assez similaire et que nous avons utilisé une seule table mais on a pas testé les performances entre plusieurs tables et une seule. C’était intéressant de demander.
Gilad, tu avais une autre question pour Vincent, à propos de comment tu as déployé ClickHouse, est-ce que tu as utilisé Kubernetes. Vincent, il semble que tu as utilisé
docker-compose, est-ce bien ça ?
Oui. Parce que c’est toujours un peu un PoC, mais comme cela marche si bien, on
a pas essayé de faire mieux. Je ne m’attendais pas que tout tienne dans une
seule VM. Pour le moment, c’est toujours un peu un essai, mais on est allé en
production comme ça. Donc c’est une seule VM avec docker-compose. Vous faites
docker-compose up et vous obtenez quelque chose qui fonctionne. Donc tout
tourne dans des conteneurs, y compris ClickHouse. Il n’y a pas de cluster. C’est
un déploiement sur un seul nœud.
Cool. Oui, c’est un très bon exemple. J’ai une question. Je n’ai pas vu de questions sur Youtube. Si vous voulez poser des questions, vous pouvez le faire dans le chat. Vincent, j’en ai une. L’interface web est superbe. Comment as-tu construit ça ?
Ça a été un peu pénible car je ne suis pas dev JavaScript. Il s’agit de vue.js. Celui-ci. C’est ce framework. Avec TailwindCSS. Ce framework. C’est tout. Je pense que c’est expliqué un peu dans la documentation. C’est open source, donc vous pouvez aller regarder. Un composant important, c’est les graphiques. Il s’agit de ECharts. C’est un projet Apache qui s’appelle ECharts. C’est lui qui fait les graphiques et c’est un super projet si vous avez besoin de développer une interface avec des graphiques. C’est très robuste et polyvalent. J’ai mis pas mal de temps avant de le trouver.
Oui, elle est superbe et l’interactivité est exceptionnelle. C’est très cool. Bien. Y a-t-il d’autres questions pour Vincent avant de passer à la suite ? Oui, il y en a une autre. Est-ce que vous avez un plan pour analyser HTTP ? À propos de la couche 7.
Chez Free, on utilise le protocole NetFlow et ce protocole ne permet pas d’aller regarder ce qui se passe en couche 7. On aurait dû utiliser sFlow. Aussi, on est un FAI et on a pas vraiment besoin de ça. Donc, rien n’est planifié pour le moment. C’est principalement pour les opérateurs réseaux telecom et ceux en datacenter. Cela pourrait être intéressant, mais pas prévu pour le moment.
Merci ! Merci pour toutes ces questions. Je crois que je ne vois pas d’autres questions sauf si je me trompe. Vincent. Merci beaucoup pour cette présentation. C’était très enrichissant. Et je pense qu’on peut t’accorder le titre d’ingénieur de bases de données honoraire. Tu as tout bien fait.